
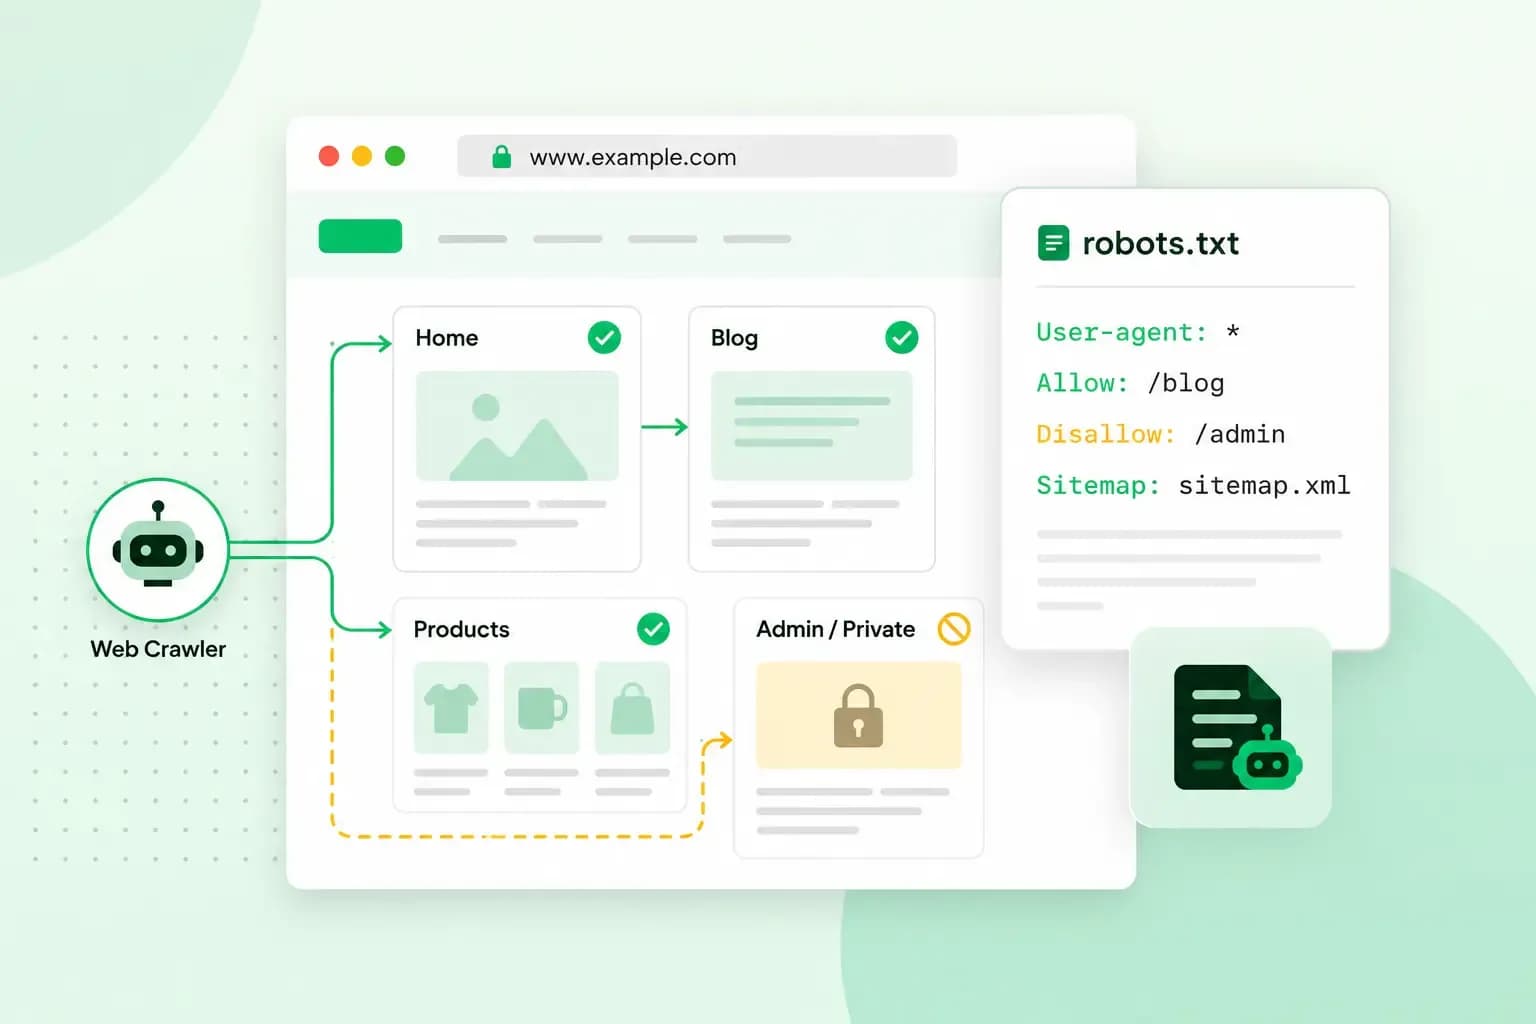
Robots.txt is een klein tekstbestand in de hoofdmap van je website. Het vertelt zoekmachines en andere crawlers, de programma's die automatisch websites lezen, welke delen van je site ze mogen bezoeken en welke niet. Je vindt het altijd op hetzelfde adres, bijvoorbeeld www.atelierlindegroen.be/robots.txt. Het bestand regelt wat crawlers lezen. Of een pagina in de zoekresultaten van Google verschijnt, regel je er niet mee.
Wat doet een robots.txt-bestand?
Een robots.txt-bestand bepaalt welke bestanden crawlers zoals Googlebot op je site mogen opvragen. De automatische crawlers van Google houden zich aan die regels. Zo hou je crawlers bijvoorbeeld weg uit de beheeromgeving van je website of uit een map met testpagina's.
Crawlen en indexeren zijn twee verschillende stappen. Bij het crawlen downloadt Google met zijn crawlers de tekst, afbeeldingen en video's van de pagina's die het gevonden heeft. Bij het indexeren analyseert Google die inhoud en bewaart het de informatie in de Google-index, een grote database. Robots.txt regelt alleen het crawlen.
Voor afbeeldingen en video's heeft een blokkade wel gevolgen in Google. Google kan ze niet indexeren zonder ze te crawlen. Als je ze in robots.txt blokkeert, verschijnen ze dus ook niet in de zoekresultaten. Een gewone pagina die je blokkeert, kan wel nog in Google opduiken.
Heb je een robots.txt-bestand nodig?
Nee, niet altijd. Heb je geen robots.txt-bestand, dan is dat volgens Google geen probleem: Google kan dan alle URL's op je site crawlen. Voor een kleine website met een handvol pagina's is dat meestal precies wat je wil.
Een robots.txt-bestand is wel nuttig als je crawlers wil weghouden van delen van je website die niet in zoekmachines thuishoren. Het is ook de plek waar je zoekmachines naar je sitemap wijst.
Werk je met WordPress of een websitebouwer, dan maakt die vaak zelf een robots.txt-bestand aan. Zie je op /robots.txt regels die je nooit geschreven hebt, dan kunnen ze daarvandaan komen. Bij een websitebouwer kan je het bestand soms niet rechtstreeks aanpassen, en dan is er misschien een instelling waarmee je zoekmachines vertelt of ze een pagina mogen crawlen. In WordPress kan je de regels bijvoorbeeld aanpassen met de SEO-plug-in Yoast SEO.
Hoe ziet een robots.txt-bestand eruit?
Een robots.txt-bestand is een gewoon tekstbestand met een of meer groepen regels. Zo ziet een eenvoudig bestand voor atelierlindegroen.be eruit:
User-agent: *
Disallow: /admin/
Allow: /admin/prijslijst.pdf
Sitemap: https://www.atelierlindegroen.be/sitemap.xml- User-agent. Hiermee kies je voor welke crawler de regels gelden. Met
*bedoel je alle crawlers, op de advertentiecrawlers van Google (AdsBot) na, en metGooglebotalleen de crawler van Google. - Disallow. Dit is een pad dat de crawler niet mag crawlen.
Disallow: /admin/houdt crawlers weg uit de map/admin/en alles wat erin staat. - Allow. Dit is een pad dat wel gecrawld mag worden, ook binnen een map die je blokkeert. In het voorbeeld mag de prijslijst in
/admin/dus wel gelezen worden. - Sitemap. Hier zet je het volledige adres van je sitemap.
Als regels elkaar tegenspreken, volgen crawlers de regel met het langste pad, en bij twee even specifieke regels kiest Google de minst strenge. Een pad begint altijd met / en is hoofdlettergevoelig, dus /Admin/ is een ander pad dan /admin/. Staat er voor een crawler geen enkele regel, dan mag die je hele site crawlen.
Patronen met * en $
Google, Bing en andere grote zoekmachines ondersteunen twee jokertekens, waarmee je een hele groep URL's tegelijk aanpakt. Een * staat voor nul of meer willekeurige tekens en een $ voor het einde van de URL. Met Disallow: /*.php$ hou je crawlers bijvoorbeeld weg van alle URL's die op .php eindigen.
Crawl-delay en Google
In sommige robots.txt-bestanden staat een regel Crawl-delay, waarmee je crawlers vraagt om trager door je website te gaan. Google ondersteunt die regel niet. Googlebot leest alleen User-agent, Allow, Disallow en Sitemap.
Krijgt je server het moeilijk door de crawlers van Google? Dan raadt Google aan om samen met je hostingprovider de recente toegangslogs van je server te bekijken. Zo zie je waar al die verzoeken vandaan komen.
Regels voor AI-crawlers
Ook voor AI-training kan je robots.txt gebruiken. Google heeft daarvoor een aparte naam: Google-Extended. Zet je User-agent: Google-Extended met daaronder Disallow: / in je bestand, dan geef je dat aan. De inhoud die Google op je site crawlt, mag het dan niet gebruiken om toekomstige generaties van de Gemini-modellen te trainen. Volgens Google heeft Google-Extended geen invloed op de opname van je site in Google Search en is het ook geen rankingsignaal.
Een robots.txt-bestand maken
Het bestand hoort in de hoofdmap van je website, dus op www.atelierlindegroen.be/robots.txt en niet in een submap. Het geldt alleen voor het domein of subdomein waarop het staat, en ook alleen voor het protocol (http of https) en de poort van dat adres. Een subdomein zoals shop.atelierlindegroen.be heeft dus een eigen robots.txt-bestand nodig.
- Maak het bestand aan. Maak met een gewone teksteditor, zoals Kladblok op Windows, een bestand met de naam
robots.txt. Bewaar het in UTF-8. - Zet je regels in het bestand. Schrijf per crawler een groep met
User-agenten daaronder je Disallow- en Allow-regels, en eventueel je sitemap. - Upload het bestand naar de hoofdmap van je website. Zet het bij de andere bestanden van je website, zodat het op
/robots.txtte openen is. - Test het bestand. Open het adres in je browser en kijk in Search Console of Google het zonder fouten leest.
Uploaden kan je bijvoorbeeld met de bestandsbeheerder in het configuratiescherm van je webhosting of met een FTP-programma zoals FileZilla. De hoofdmap is de map waarin ook de startpagina van je website staat. Weet je niet hoe je bij die map komt, dan helpt je hostingprovider je verder.
Met webhosting staan de bestanden van je website op een server. Daar zet je ook je robots.txt, in de hoofdmap bij de rest van je website.
Bekijk de hostingpakkettenJe robots.txt checken in Search Console
De eenvoudigste check doe je in je browser. Typ het adres van je website gevolgd door /robots.txt. Zie je je regels, dan staat het bestand op de juiste plaats.
Een aparte robots.txt checker heb je niet nodig. Of Google het bestand ook goed leest, zie je in het robots.txt-rapport van Google Search Console. Het toont welke robots.txt-bestanden Google voor de top 20 hosts van je site heeft gevonden, wanneer ze voor het laatst gecrawld zijn en welke waarschuwingen of fouten erin staan. Regels met een fout negeert Google, de andere regels gebruikt het wel.
Het rapport werkt alleen voor een property op domeinniveau. Een property is je website zoals je die in Search Console toevoegt. Dat moet het hele domein zijn, zoals atelierlindegroen.be, of een adres zonder pad, zoals https://www.atelierlindegroen.be/, en geen submap zoals https://www.atelierlindegroen.be/blog/.
Wil je weten of één bepaalde pagina geblokkeerd is, dan typ je het adres van die pagina in het vak voor URL-inspectie in Search Console. In het resultaat staat het veld Crawl toegestaan?. Daar zie je of Google de pagina mag crawlen of dat een robots.txt-regel ze blokkeert.
Als je een fout verbeterd hebt, leest Google je nieuwe bestand normaal binnen 24 uur. Moet het sneller, dan vraag je in het robots.txt-rapport een nieuwe crawl aan. Verander je later de mappen of adressen van je website, dan kijk je best ook je robots.txt na. Zo blokkeert een oude regel geen nieuwe pagina's.
Wat robots.txt niet doet
Robots.txt houdt een pagina niet uit Google. Google kan de inhoud van een geblokkeerde pagina niet indexeren, maar de URL kan wel in de zoekresultaten verschijnen, dan zonder beschrijving. Dat gebeurt bijvoorbeeld als andere pagina's ernaar linken.
Wil je een pagina echt uit de zoekresultaten houden, gebruik dan een noindex-regel. Dat is een korte regel in de code van de pagina zelf of in de HTTP-header die de server meestuurt, die Google vraagt om de pagina niet in de zoekresultaten op te nemen. In WordPress stel je die bijvoorbeeld per pagina in met een SEO-plug-in zoals Yoast SEO. Blokkeer die pagina dan niet in robots.txt, anders ziet Google de noindex-regel nooit.
Robots.txt is ook geen beveiliging. De regels zijn een verzoek aan crawlers en geen vorm van toegangscontrole. Een tool als Screaming Frog kan je zelfs zo instellen dat ze robots.txt negeert. Voor informatie die echt afgeschermd moet zijn, is dit bestand dus de verkeerde plek. Zulke informatie zet je achter een wachtwoord. Lees ook onze tips om je website te beveiligen.
Een te ruime regel kan je website ook schaden. Met Disallow: / onder User-agent: * hou je alle crawlers weg van je hele site, op de advertentiecrawlers van Google (AdsBot) na. Googlebot leest dan geen enkele pagina meer, ook je nieuwe pagina's niet.
Je robots.txt op je eigen website
Open nu /robots.txt op je eigen domeinnaam en kijk of de regels overeenkomen met wat crawlers wel en niet mogen lezen. Heb je een webhostingpakket bij ons? Dan zet je je robots.txt met de bestandsbeheerder in je configuratiescherm in dezelfde map als je startpagina.
Aanbevolen blogartikelen
 Online Marketing19 okt 2026
15 ideeën voor Black Friday-marketing
Haal het maximale uit Black Friday met 15 marketingideeën om klanten aan te trekken en je verkoop te boosten. Ontdek hoe je je aanbod promoot, meer shoppers bereikt en je campagne laat opvallen. Online Marketing30 dec 2025
AI en SEO: een gids voor zoekmachineoptimalisatie met AI
AI en SEO: een eenvoudige gids. Ontdek hoe slimme technologie je SEO werk makkelijker en sneller maakt. Online Marketing11 nov 2025
Wat zijn topic clusters?
SEO topic clusters helpen jou met het bouwen van autoriteit over bepaalde onderwerpen. Word snel beter zichtbaar! Ontdek hier hoe je deze clusters maakt.